

SLO: guia de implementação por vertical de serviço
 Autor: Pedro Tebaldi PM do KeepGreen
 Revisão técnica: Ednilson Correa SRE
Um SLO (Service Level Objective) é a meta de confiabilidade de um serviço. Ele fixa o valor que um indicador precisa atingir dentro de uma janela de tempo. Por exemplo, 99,9% das requisições respondem com sucesso a cada 30 dias. Assim, esse número separa o comportamento aceitável da degradação que exige ação.
Dois elementos sustentam o SLO. O SLI é o indicador medido; o error budget, por outro lado, é a folga entre a meta e os 100%. Quando o budget está cheio, o time pode acelerar. Em contrapartida, quando está consumido, a confiabilidade vira prioridade. Como parte de uma estratégia de observabilidade, o SLO liga a telemetria às decisões de negócio.
Times que implementam SLOs pela primeira vez quase sempre cometem o mesmo erro: definem o objetivo antes de entender o serviço. Como resultado, saem metas de 99,99% que consomem o budget em horas, ou de 90% que nunca disparam alerta.
Neste guia você encontra os thresholds de referência por tipo de serviço e o tempo fora do ar que cada meta permite. Além disso, um laboratório com Prometheus mostra por que medir latência pela média esconde a violação do SLO.
Como definir o SLO certo: o processo antes dos números
O ponto de partida não é escolher um número. Antes de tudo, responda a três perguntas. Qual é o comportamento mínimo aceitável para o usuário? Qual é o comportamento que o serviço entrega historicamente? Qual é o custo de ultrapassar esse limite?
Dados de suporte e de negócio respondem à primeira pergunta. A segunda sai do histórico de métricas dos últimos 30 a 90 dias. Por fim, a terceira é uma decisão de produto e engenharia.
Nesse sentido, o SRE do Google tem uma recomendação clara no capítulo Service Level Objectives do SRE Book: defina o SLO um pouco abaixo do desempenho histórico real. Dessa forma, sobra margem operacional. Um serviço que atinge 99,8% de disponibilidade deve ter SLO de 99,5%, não de 99,99%, que seria inatingível sem investimento pesado.
Na tabela abaixo estão os thresholds que cada seção deste guia detalha, com o indicador correspondente e a janela de cálculo.
| Vertical de serviço | SLI | Threshold | Janela |
|---|---|---|---|
| API de missão crítica pagamento, autenticação |
Disponibilidade | 99,9% |
30 dias rolling |
| API de missão crítica | Latência | P95 abaixo de 300 ms |
30 dias rolling |
| API secundária relatórios, notificações |
Disponibilidade | 99,5% |
30 dias rolling |
| API de consulta pesada joins complexos |
Latência | P95 abaixo de 1 s |
30 dias rolling |
| Checkout de e-commerce | Disponibilidade | 99,95% |
30 dias rolling |
| Checkout de e-commerce | Latência | P95 abaixo de 500 ms |
30 dias rolling |
| Busca de produtos | Latência | P95 abaixo de 800 ms |
30 dias rolling |
| Pipeline de dados | Frescor | 95% dos jobs em até 30 min do horário agendado | por ciclo de execução |
| Pipeline de dados | Completude | 99% dos registros esperados no destino | por ciclo de execução |
| Uplink de rede | Disponibilidade | 99,9% |
30 dias rolling |
SLOs para APIs e serviços web transacionais
Disponibilidade
Para APIs, a janela padrão é de 30 dias com cálculo rolling, não de calendário. O threshold varia conforme a criticidade. APIs de pagamento e autenticação ficam em 99,9%. APIs de relatórios e notificações ficam em 99,5%. Por fim, as APIs internas de suporte ficam em 99,0%.
Cada meta equivale a um tempo máximo fora do ar. A janela de 30 dias tem 43.200 minutos. Assim, o budget sai desta conta.
| Meta de disponibilidade | Budget em 30 dias | Equivale a |
|---|---|---|
| 99,99% quatro noves | 4,3 minutos | menos de 5 min por mês |
| 99,95% | 21,6 minutos | uma janela curta de manutenção |
| 99,9% três noves | 43,2 minutos | pouco mais de 40 min por mês |
| 99,5% | 216 minutos | 3,6 horas |
| 99,0% dois noves | 432 minutos | 7,2 horas |
Latência
Todo SLO de latência precisa fixar o percentil e o threshold juntos. Por exemplo, 95% das requisições respondem em menos de 300ms. Como referência por tipo, APIs síncronas de dados críticos usam P95 < 300ms. APIs de consulta com joins complexos usam P95 < 1s. Já os relatórios aceitam P95 < 5s, com feedback assíncrono ao usuário.
Medir latência pela média parece equivalente, mas não é. Para mostrar a diferença, subimos um serviço sintético com Prometheus 3.7.3 em 3 de setembro de 2026. O gerador manteve 50 requisições por segundo, com objetivo de P95 < 300ms.
Na fase degradada, 8% das requisições passaram a responder em cerca de 1,2 segundo. No entanto, as outras 92% seguiram em torno de 80 ms. As duas consultas abaixo leem a mesma série, no mesmo instante.
Esse recorte separa as duas leituras sem margem para dúvida.
| Leitura da mesma série | Latência média | Latência P95 |
|---|---|---|
| Fase saudável | 80,1 ms | 99,9 ms |
| Fase degradada | 169,9 ms | 1.188,6 ms |
| Veredito contra o objetivo de 300 ms | Passa, e nenhum alerta dispara | Falha, e o alerta dispara |
Repare no contraste: a média ficou 130 ms abaixo do objetivo, portanto nenhum alerta dispararia. Ao mesmo tempo, o P95 estava quase quatro vezes acima do limite. Por isso o SLO de latência se escreve em percentil, nunca em média.
O guia completo de SRE, em 35 páginas.
Escrito pelo time da OpServices: fundamentos da engenharia de confiabilidade, o que faz um SRE, as métricas que medem confiabilidade de verdade e a rotina de um time — do primeiro conceito ao plantão.
Só o e-mail. Sem spam, e seus dados protegidos pela LGPD.
SLOs para plataformas de e-commerce
Em e-commerce, o SLO deve seguir o funil de conversão, não só a disponibilidade técnica. Inclusive, os endpoints mais críticos, como busca de produtos, adição ao carrinho e checkout, exigem SLOs mais restritivos que o restante da aplicação.
Por isso, a estrutura separa os dois grupos. O checkout fica com 99,95% de disponibilidade em 30 dias e P95 < 500ms de latência. Já a busca fica com 99,9% de disponibilidade e P95 < 800ms.
Essa separação entre endpoint crítico e não crítico permite alocar o error budget de forma assimétrica. Como resultado, uma degradação na página de FAQ consome menos budget do que uma no fluxo de pagamento.
SLOs para sistemas de dados e pipelines
Pipelines de dados têm perfil diferente, porque a latência de uma requisição individual não é a métrica relevante. Isto é, os SLOs que importam aqui são de frescor e de completude.
Frescor mede o atraso: 95% dos jobs de ETL completam em até 30 minutos do horário agendado. Por outro lado, completude mede a perda: 99% dos registros esperados estão presentes na tabela de destino após a execução.
Vale destacar que a janela para pipelines costuma ser medida por ciclo de execução, não em dias corridos. Um pipeline que roda a cada hora tem o SLO calculado por ciclo. Ou seja, quantos dos últimos 720 ciclos completaram dentro do threshold.
SLOs para infraestrutura e redes
Em infraestrutura, os SLOs mais relevantes cobrem a disponibilidade de componentes críticos, como balanceadores, DNS e gateways. Somado a isso, entra a latência de rede.
Para monitoramento de redes, o SLO de disponibilidade de uplink costuma ficar em 99,9%. Além disso, o time define alertas para latência acima do threshold de cada tipo de tráfego.
Janelas de tempo: rolling ou calendário
Toda escolha de janela afeta o comportamento operacional do SLO. Janelas de calendário criam um efeito de reinicialização no primeiro dia do mês, porque o time pode ser mais agressivo no início do período. Em contrapartida, janelas rolling mantêm pressão constante e são a recomendação padrão do SRE.
Para serviços com sazonalidade marcada, como a Black Friday, janelas multi-período ajudam a contextualizar o desempenho. Nesse sentido, vale um SLO padrão para dias normais e outro de contingência para os picos declarados.
Outro ponto: a janela também decide quando o alerta dispara. O capítulo de alertas do SRE Workbook resolve isso com o burn rate, que é a velocidade de consumo do budget em relação ao permitido.
Nesse capítulo, a Tabela 5-8 recomenda três pares de janelas para um SLO de 99,9%. Um burn rate de 14,4 sustentado por uma hora consome 2% do budget mensal e pede acionamento imediato. Assim, a regra combina uma janela longa e uma curta: a longa confirma o volume, a curta confirma que a queima continua acontecendo agora.
No laboratório, a taxa de erro subiu para 2,2441% contra um budget de 0,1%. Ou seja, um burn rate de 22,4 vezes. Nesse ritmo, o budget de 30 dias inteiro se esgota em 32 horas. O alerta disparou 226 segundos depois do início da degradação, já com as duas janelas em acordo.
Na tela de alertas do Prometheus aparecem a regra ativa, o limiar de 14,4 e o valor medido no instante da captura.
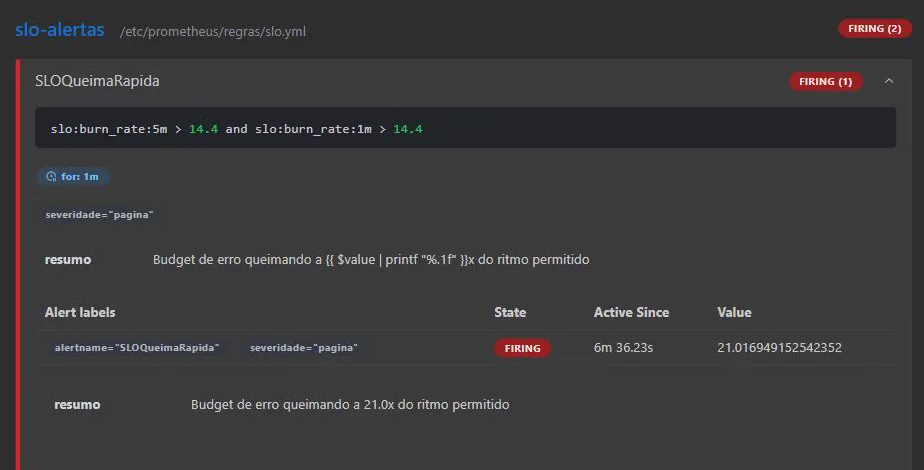
Cabe ressaltar que as janelas do laboratório foram comprimidas para 5 minutos e 1 minuto. A fórmula é a mesma que o SRE Workbook aplica a 1 hora e 5 minutos: apenas a escala de tempo muda, para o teste caber em 11 minutos.
Transformamos operações reativas em engenharia de confiabilidade (SRE).
Implementamos SLIs, SLOs e Error Budgets para reduzir o MTTR e eliminar a fadiga de alertas das suas equipes de operação.
Conclusão
Definir SLOs por vertical de serviço é o que transforma metas genéricas de disponibilidade em instrumento operacional. Em resumo, a distinção entre o SLO de checkout e o de relatórios separa o que exige rigor do que não exige. Essa distinção permite alocar error budget de forma estratégica.
O passo seguinte é instrumentar os SLIs com dados reais de produção e ligar os alertas ao fluxo de resolução de incidentes. Para implementar SLOs calibrados no seu ambiente com suporte técnico especializado, fale com nossos especialistas.
Perguntas Frequentes
O que é um SLO (Service Level Objective)?
Qual a diferença entre SLO e SLA?
Como escolher o threshold correto para um SLO?
Janela rolling ou janela de calendário para SLOs?
