

O que é e como funciona um cluster?
 Autor: Pedro Tebaldi PM do KeepGreen
 Revisão técnica: Ednilson Correa SRE
Em ambientes de TI corporativa, depender de um único servidor para sustentar aplicações críticas é um risco que poucos gestores aceitam conscientemente. Quando esse servidor falha, tudo para. A resposta da computação para esse problema tem nome: cluster.
Um cluster é um conjunto de servidores interconectados que operam como um único sistema, distribuindo carga, garantindo continuidade e escalando capacidade sem interrupção. Por isso, é a base da alta disponibilidade em infraestruturas modernas.
Neste guia, você vai entender o que é cluster, como ele funciona e quais são os tipos. Além disso, cada categoria aparece com números medidos em laboratório.
O que é um cluster em computação?
Um cluster é um agrupamento de dois ou mais computadores, chamados de nós, conectados em rede. Um software especializado os gerencia e os faz operar como uma única unidade lógica. Do ponto de vista de quem usa, o cluster se comporta como uma máquina só. Por isso, o ganho aparece em disponibilidade, em capacidade ou nos dois ao mesmo tempo.
Essa ideia surgiu na IBM nos anos 1960, para interligar mainframes. Já o marco moderno foi o projeto Beowulf, montado em 1994 no Goddard Space Flight Center da NASA. Segundo o registro histórico do projeto, o protótipo tinha 16 processadores DX4 ligados por Ethernet comum.
Nesse sentido, o princípio central continua o mesmo desde então. Hardware simples e barato, operando em conjunto, supera um único servidor caro em disponibilidade, em desempenho ou em custo.
Como funciona um cluster de servidores?
Todo cluster se apoia em três camadas que operam em conjunto.
Nós (nodes)
Cada servidor do cluster é um nó independente, com processador, memória e armazenamento próprios. Os nós podem ser físicos ou virtuais. Além disso, precisam compartilhar o mesmo sistema operacional e responder ao software de cluster.
Rede de interconexão
Os nós trocam dados por uma rede de alta velocidade, em geral Ethernet ou InfiniBand. Assim, a latência dessa rede decide o que o cluster consegue fazer. No laboratório descrito abaixo, uma troca de 8 bytes entre dois processos no mesmo nó levou 0,15 microssegundo. Entre nós diferentes, pela rede, a mesma troca levou 10,7 microssegundos, ou seja, 70 vezes mais.
Software de gerenciamento
Cabe ao software de cluster monitorar o estado de cada nó, distribuir tarefas e executar o failover automático quando um nó falha. Por exemplo, Pacemaker, Corosync, Kubernetes e balanceadores como o HAProxy cumprem esse papel. Em ambientes modernos, a integração com plataformas de monitoramento de servidores permite detectar degradação antes da falha completa.
Todos os números deste artigo saíram de um laboratório próprio, montado em 3 de setembro de 2026. São três nós de aplicação atrás de um HAProxy 3.2.23 e três nós de cálculo com MPICH 4.2.1, todos em Docker 29.6.1 sobre WSL2.
Como os seis nós dividem a mesma máquina física, o tempo absoluto vale como ordem de grandeza. Por isso, toda comparação aqui é a mesma medida antes e depois de uma única mudança.

Tipos de cluster: quais são e quando usar cada um
Existem três categorias de cluster, cada uma otimizada para um objetivo diferente. A tabela abaixo resume o critério de escolha e o que cada tipo entregou no laboratório.
| Dimensão | Alta disponibilidade | Balanceamento de carga | Alto desempenho (HPC) |
|---|---|---|---|
| Problema que resolve | o serviço não pode cair quando um nó falha | um nó só não dá conta do volume de requisições | o cálculo não termina no prazo em uma máquina |
| Sinal de que é o seu caso | há SLA contratado e a parada tem multa | a fila cresce no pico com CPU sobrando em outro nó | o trabalho se divide em partes grandes e independentes |
| O que medir | tempo até o nó sair do rodízio e requisições afetadas na janela | distribuição por nó e percentil 95 do cluster | tempo total e ganho por processo acrescentado |
| Software típico | Pacemaker Keepalived |
HAProxy NGINX |
MPI Slurm |
| Armadilha conhecida | nó travado não é nó morto: aceita a conexão e devolve erro só no timeout | o revezamento simples trata nós desiguais como iguais | sincronizar demais deixa o cluster mais lento que uma máquina |
| Medido no laboratório | 11,9 s até o nó sair do rodízio, com 47 requisições a 2,02 s | 76% mais requisições por segundo trocando o algoritmo | 5,8 vezes mais rápido com 12 processos em 3 nós |
Cluster de alta disponibilidade (High Availability, HA)
O cluster de alta disponibilidade mantém o serviço no ar quando um ou mais nós falham. Assim que um nó cai, o software redireciona o tráfego para os nós saudáveis, processo chamado de failover.
São duas as configurações principais. No modelo ativo-ativo, todos os nós processam requisições ao mesmo tempo. Por outro lado, no modelo ativo-passivo, o nó secundário fica em espera e assume apenas quando o primário falha.
Dizer que o failover acontece “em segundos” não ajuda quem precisa definir um limiar de alerta. Por isso, derrubamos um de três nós com tráfego contínuo passando pelo balanceador. O resultado depende muito mais de dois parâmetros da verificação de saúde do que do failover em si.
Com a configuração de partida, o balanceador levou quase 12 segundos para tirar o nó morto do rodízio. Nenhum cliente viu erro, porque o retries somado ao option redispatch reenviou cada requisição para outro nó. Ainda assim, uma em cada três requisições ficou 2 segundos parada nesse intervalo.
Apertar a verificação de saúde muda a escala do problema. Dessa forma, a janela caiu de 11,9 s para 2,2 s e as requisições degradadas caíram de 47 para 8. O significado de cada parâmetro está na documentação de configuração do HAProxy.
Na tela de estatísticas do balanceador aparecem o nó reprovado, o motivo da reprovação e o tempo acumulado de queda.
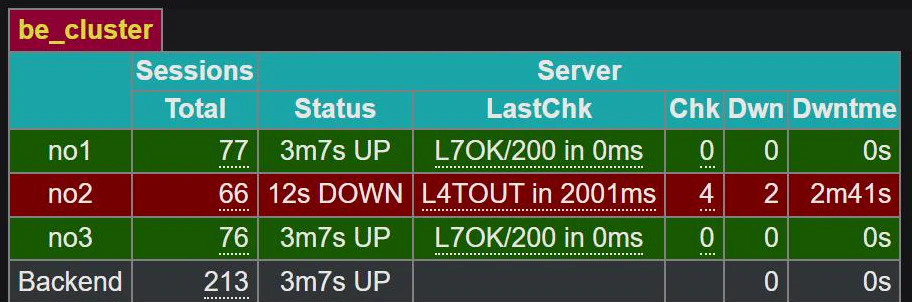
Existe um caso pior que o nó morto: o nó travado. Ao congelar o mesmo nó em vez de derrubá-lo, ele continuou aceitando conexão sem nunca responder. Como resultado, as 18 requisições que caíram nele voltaram como HTTP 504 depois de 10 segundos de espera. O redispatch não reenvia requisição já entregue.
Casos de uso: bancos de dados críticos, sistemas financeiros, ERPs corporativos, e-commerce e qualquer aplicação com SLA de uptime acima de 99,9%.
Cluster de balanceamento de carga (Load Balancing)
O cluster de balanceamento de carga distribui as requisições entre os nós disponíveis, para que nenhum servidor fique sobrecarregado. O algoritmo decide como: o round-robin faz revezamento, enquanto o leastconn escolhe quem tem menos conexões abertas.
Essa escolha parece detalhe até os nós deixarem de ser idênticos. No laboratório, demos ao terceiro nó dez vezes mais trabalho por requisição, simulando hardware mais antigo. Em seguida, rodamos a mesma carga com os dois algoritmos.
Round-robin trata igual quem não é igual. Ele manda um terço das conexões para o nó lento. Como resultado, a fila se forma ali e o percentil 95 do cluster inteiro vai a 1,7 segundo. Já o leastconn para de entregar conexão a quem não devolveu as anteriores.
Vale como regra prática: com nós idênticos, o revezamento basta. Por outro lado, com nós desiguais ou requisições de custo variável, ele vira o gargalo.
Cluster de alto desempenho (High Performance Computing, HPC)
O cluster HPC agrupa dezenas a milhares de nós para executar cálculo científico, simulação e processamento paralelo. Ou seja, em vez de um supercomputador único, usa hardware convencional em quantidade.
Entre os processos, a comunicação segue o padrão MPI. Para medir o ganho real, rodamos a mesma integração numérica com 1, 4 e 12 processos espalhados por três nós.
Esse ganho não é linear. De 1 para 4 processos, o tempo caiu 3,42 vezes. No entanto, de 4 para 12, caiu apenas mais 1,68 vez, porque cada processo novo rende menos que o anterior.
Nas duas últimas linhas aparece a armadilha que derruba projeto de HPC. Quando os 12 processos param para sincronizar a cada 1.000 passos, o mesmo cálculo fica 337 vezes mais lento que em um processo só. Ou seja, o cluster passa o tempo conversando pela rede em vez de calcular. Portanto, paralelizar só acelera quando o pedaço de trabalho custa mais que a troca de mensagens.
Aplicações típicas: simulação meteorológica, pesquisa genômica, treinamento de modelos de IA e análise financeira de alta frequência.
Cluster vs. virtualização vs. cloud: entenda as diferenças
Esses três conceitos costumam se confundir, mas respondem a problemas diferentes.
A virtualização cria múltiplas máquinas virtuais em um único servidor físico, o que aumenta a utilização do hardware. O cluster, por sua vez, conecta múltiplos servidores para operar como um. Inclusive, os dois são complementares: clusters costumam ser formados por servidores virtualizados.
Já a cloud computing oferece infraestrutura sob demanda gerenciada por terceiros. Em ambientes de cloud, os clusters existem dentro da plataforma. Por exemplo, AWS EKS, Azure AKS e Google GKE são serviços de cluster Kubernetes gerenciados pelos provedores.
Para o gestor de TI, a distinção prática é simples. Virtualização resolve eficiência de hardware, cluster resolve disponibilidade e escala, cloud resolve flexibilidade e custo operacional.
Cluster e Kubernetes: o padrão moderno
Em ambientes cloud-native, o conceito de cluster evoluiu com o Kubernetes (K8s). Assim, um cluster Kubernetes tem duas partes: o control plane, que gerencia o estado, mais os worker nodes, que executam as cargas em containers.
O Kubernetes automatiza o que um cluster tradicional faz na mão. Ele distribui workloads, reinicia containers com falha, escala conforme a demanda e faz rollout de atualização sem downtime.
Em 2026, praticamente toda arquitetura de microsserviços em produção roda sobre um cluster Kubernetes, seja on-premises, em cloud pública ou em ambiente híbrido. Além disso, a observabilidade desses clusters costuma sair de stacks como Prometheus e Grafana, que coletam métricas de cada nó e pod em tempo real.
Vantagens de usar cluster em infraestrutura corporativa
Na operação de TI, a adoção de clusters traz quatro benefícios mensuráveis.
Alta disponibilidade: eliminação do ponto único de falha. Se um nó falha, o serviço continua. Assim, o SLA de 99,99% fica ao alcance, o equivalente a menos de 53 minutos de indisponibilidade por ano.
Escalabilidade horizontal: acrescentar capacidade significa incluir um novo nó, sem interrupção. Logo, não há necessidade de trocar hardware por um modelo maior.
Redução de custo: hardware convencional em cluster entrega desempenho de supercomputador a custo muito inferior. Além disso, a consolidação de serviços reduz o número total de servidores gerenciados.
Gerenciamento centralizado: o software de cluster trata todos os nós como uma unidade, o que simplifica patching, monitoramento e operação.
Monitoramento de clusters: como manter visibilidade total
Um cluster sem monitoramento é um cluster que falha de surpresa. Portanto, a gestão desse tipo de infraestrutura exige visibilidade de cada nó, além do serviço publicado.
Poucas métricas importam de verdade. A lista inclui CPU e memória por nó, tráfego de rede entre nós, estado do heartbeat, tempo de resposta das aplicações e eventos de failover.
No laboratório fica claro por que o evento de failover merece alerta próprio. Entre a queda do nó e a saída dele do rodízio existe uma janela em que o serviço responde, porém devagar. Quem observa apenas o resultado final do balanceador não enxerga esse intervalo.
Plataformas de monitoramento em tempo real permitem configurar alertas que disparam antes de o nó atingir a saturação. Dessa forma, a equipe age na janela de degradação, não depois do incidente.
Para clusters Kubernetes, por exemplo, o Prometheus com kube-state-metrics e node-exporter entrega o estado de cada pod, node e deployment. Já a integração com AIOps ajuda a correlacionar anomalias de desempenho antes que virem incidente.
Quando implementar um cluster na sua infraestrutura
Nem toda aplicação precisa de cluster. No entanto, os cenários que justificam a implementação são poucos e reconhecíveis.
Tudo começa pelo SLA que não tolera mais que alguns minutos de indisponibilidade por ano. Depois disso, vem o volume de requisições que excede a capacidade de um servidor. Por fim, entram a manutenção sem janela de downtime e o processamento pesado que exige paralelismo.
Por outro lado, aplicação interna de baixo uso, ambiente de desenvolvimento e ferramenta sem SLA crítico não pagam a complexidade operacional de um cluster.
99,9% de uptime não acontece por acidente. É resultado de engenharia.
Estruturamos arquiteturas de monitoramento proativo que elevam sua disponibilidade de forma gradativa e mensurável, com SLA garantido em contrato.
Conclusão
O cluster é a resposta da engenharia de infraestrutura para disponibilidade e escala em ambiente crítico. De um par de bancos de dados a um cluster Kubernetes de microsserviços, o princípio é o mesmo. Vários nós cooperando como um sistema único eliminam o ponto único de falha.
Esse laboratório deixa claro que o cluster não entrega isso sozinho. A disponibilidade real depende do intervalo de verificação de saúde, do timeout de conexão e do algoritmo de distribuição. Portanto, cada um desses ajustes vale segundos de degradação percebida pelo usuário.
Se você quer estruturar ou evoluir a arquitetura de cluster da sua operação com monitoramento integrado, fale com nossos especialistas.
Perguntas Frequentes
O que é um cluster em computação?
Quais são os tipos de cluster?
Qual a diferença entre cluster e virtualização?
O que é um cluster Kubernetes?
Quando vale a pena implementar um cluster?
