

NOC: o que é, como funciona, níveis de suporte e métricas operacionais
 Autor: Pedro Tebaldi PM do KeepGreen
 Revisão técnica: Ednilson Correa SRE
Toda empresa que depende de sistemas críticos para operar tem um ponto em comum: a indisponibilidade custa caro. E o custo não é só financeiro: envolve impacto na experiência do usuário, penalidades de SLA e desgaste operacional.
O NOC (Network Operations Center), ou Centro de Operações de Rede, é a estrutura que responde por esse cenário. Seu trabalho é identificar e resolver a falha antes que ela chegue ao usuário final.
O NOC é um conjunto de profissionais, processos e ferramentas dedicado ao monitoramento contínuo da infraestrutura: servidores, redes, links, aplicações e dispositivos. Seu objetivo é detectar incidentes, executar respostas de primeiro nível e escalar o que não se resolve sozinho.
Por outro lado, o helpdesk responde ao usuário. O NOC vigia os ativos e age antes que o usuário perceba o problema.
Para gestores de TI, entender como um NOC funciona no dia a dia é parte do planejamento de uma operação madura. Isso inclui, por exemplo, a hierarquia de níveis, os indicadores de desempenho e os critérios para estruturá-lo internamente ou terceirizá-lo.
O que um NOC monitora e gerencia?
Na camada de infraestrutura que sustenta os serviços de TI, o escopo do NOC cobre três planos.
No plano de rede: disponibilidade e latência de links WAN e LAN, switches, roteadores, firewalls e pontos de acesso Wi-Fi. Assim, o monitoramento do tráfego de redes identifica anomalias de consumo de banda, congestionamento e comportamento suspeito antes que atinjam a operação.
No plano de servidores e sistemas: uso de CPU, memória e disco, status de serviços críticos, logs de erros e indicadores de performance de aplicações. Da mesma forma, o monitoramento de servidores 24×7 é a base da disponibilidade dos sistemas que o negócio usa.
Por fim, no plano de serviços de negócio: disponibilidade de ERPs, integrações com APIs externas, gateways de pagamento e serviços cloud. Aqui o NOC não olha só a infraestrutura física, mas a experiência de ponta a ponta dos serviços que o usuário consome.
Estrutura de níveis: como o NOC hierarquiza o atendimento
Em geral, o NOC opera com três níveis de suporte, organizados por complexidade e autonomia de resolução.
Nível 1 (N1): monitoramento e triagem
O N1 é a camada de entrada. Os analistas recebem os alertas das ferramentas de monitoramento e classificam o incidente por severidade. Em seguida, executam os procedimentos de estabilização de primeiro nível: reinicialização de serviço, limpeza de fila, reset de dispositivo. Depois disso, abrem o ticket no sistema de ITSM.
Quando o N1 não resolve dentro do prazo definido, ele escala o incidente.
Nível 2 (N2): diagnóstico e resolução técnica
O N2 recebe os incidentes que exigem análise técnica mais aprofundada. Aqui estão os especialistas em redes, sistemas operacionais e aplicações. Eles executam o diagnóstico de causa raiz e implementam as correções que os scripts de N1 não cobrem. Além disso, o N2 valida se a resolução foi efetiva e documenta o procedimento para enriquecer a base de conhecimento do NOC.
Nível 3 (N3): especialistas e fabricantes
No N3 estão os incidentes complexos: problemas de arquitetura, falhas de hardware, bugs de produto ou acionamento do suporte do fabricante. Em geral, esse nível é formado pelo time de engenharia de infraestrutura ou pelo fornecedor responsável pelo equipamento afetado.
NOC e SOC: qual a diferença?
A confusão entre NOC e SOC é comum. No entanto, a distinção decide quem responde por qual evento.
Disponibilidade e performance definem o foco do NOC, ou seja, manter os sistemas dentro dos parâmetros de SLA. Alta utilização de CPU, queda de link ou falha de serviço são eventos NOC.
O SOC (Security Operations Center) foca em ameaças e incidentes de segurança. Seu objetivo é detectar e responder a comportamentos maliciosos, tentativas de intrusão, vazamentos de dados e outros eventos de segurança. Por exemplo, um pico anômalo de tráfego que indica DDoS ou um acesso incomum a arquivo sensível são eventos SOC.
| Dimensão | NOC | SOC |
|---|---|---|
| Pergunta que responde | O serviço está de pé e dentro do SLA? | Alguém está agindo contra o ambiente? |
| Evento típico | queda de link, disco saturado, serviço parado, lentidão de aplicação | tentativa de intrusão, movimentação lateral, exfiltração, malware |
| Métrica que cobra | MTTD, MTTR e disponibilidade acordada | tempo de contenção e precisão da detecção |
| Origem do sinal | coleta ativa por SNMP, agente, ping e checagem de porta |
log, telemetria de endpoint e inspeção de tráfego |
| Diante de um pico de tráfego | investiga saturação e capacidade | investiga negação de serviço ou vazamento |
Na prática, as duas funções se complementam. O NOC pode identificar sintomas que o SOC precisa investigar. O contrário também acontece. Por isso, organizações maduras mantêm canais formais entre as duas equipes e critérios claros de handoff.
Métricas que definem a qualidade de um NOC
Três indicadores conectam a operação técnica ao impacto no negócio e, por isso, medem a efetividade de um NOC.
O MTTD (Mean Time to Detect) mede o tempo médio entre a ocorrência de um problema e sua detecção pelo NOC. Quanto menor, maior a proatividade da operação. Um MTTD alto, portanto, indica cobertura de monitoramento insuficiente ou limiar de alerta mal calibrado.
O piso do MTTD, medido em laboratório
Antes de cobrar MTTD da equipe, contudo, vale medir o piso que a coleta impõe. Em 3 de setembro de 2026 subimos um Zabbix 7.4.14 com um serviço HTTP vigiado por três regras ao mesmo tempo. Em seguida derrubamos o serviço uma única vez e registramos quando cada regra abriu o alerta.
| Configuração da detecção | Alerta chegou em | O que vem junto |
|---|---|---|
| Coleta a cada 30s, alerta na 1ª falha mais rápido | 21s | o dobro de coletas por item e nenhuma tolerância a oscilação curta |
| Coleta a cada 60s, alerta na 1ª falha padrão | 52s | o intervalo de coleta vira o piso da detecção |
| Coleta a cada 60s, alerta na 3ª falha seguida mais silencioso | 2min 51s | ignora oscilação curta, mas atrasa a falha real na mesma proporção |
Repare no intervalo: a mesma falha chegou ao operador em 21 segundos ou em quase três minutos. Nada disso passa pelo analista. Quem decide é a configuração: o intervalo de coleta e a função escolhida na regra. Portanto, um MTTD de 15 minutos costuma ser limite de projeto, não desatenção de plantão.
Na fila do operador, a mesma queda aparece como três incidentes distintos, cada um com o horário em que a sua regra enxergou a falha.
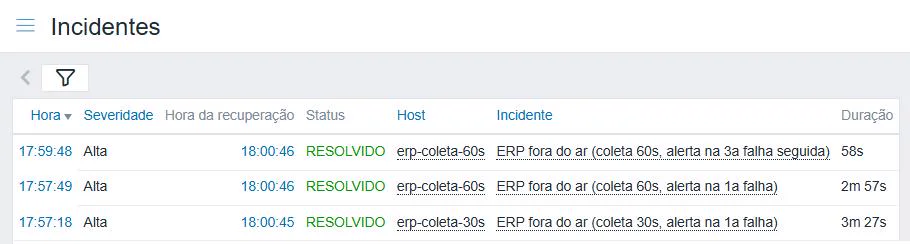
Vale um cuidado de sintaxe. Num item que devolve 0 ou 1, a função min() sobre três amostras dispara já na primeira falha. Afinal, o menor valor da janela vira zero. Portanto, quem quer confirmação de três coletas seguidas precisa de max(), como descreve a documentação de expressões de gatilho.
O MTTR (Mean Time to Repair) mede o tempo médio entre a detecção e a resolução do incidente. Ou seja, é o indicador mais direto da eficiência operacional do NOC. Por isso, reduzir o MTTR muda a disponibilidade dos sistemas e o cumprimento de SLAs.
A taxa de falsos positivos mede a proporção de alertas que não representam incidentes reais. Em contrapartida, uma taxa alta gera fadiga de alertas na equipe e derruba a atenção aos eventos realmente críticos.
Além disso, o laboratório mediu o custo dessa escolha. Cinco quedas reais de 35 segundos, todas com recuperação automática, abriram cinco alertas na regra de coleta rápida. A regra de 60 segundos abriu três. Por outro lado, a que exige três coletas seguidas não abriu nenhum.
Repare no número do meio. A coleta de 60 segundos não filtrou dois alertas: duas quedas couberam inteiras entre uma coleta e a seguinte. Alargar o intervalo reduz ruído e cria ponto cego na mesma proporção.
Do lado de quem está de plantão, sete minutos de oscilação renderam esta fila, toda ela do mesmo serviço.
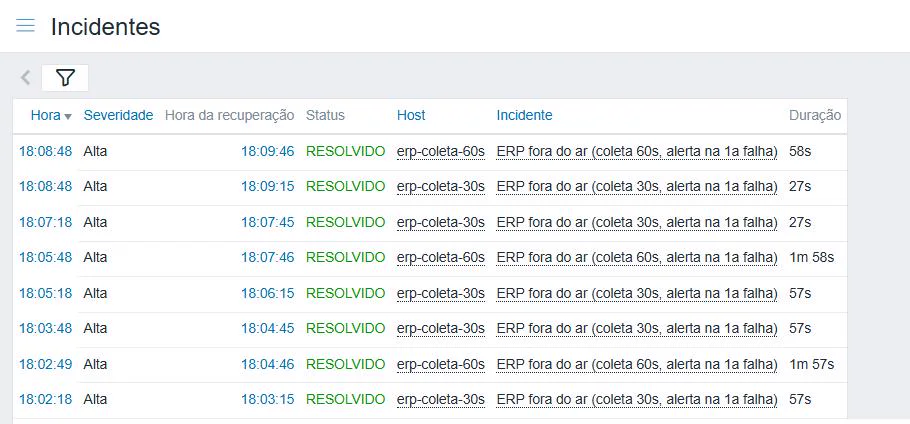
Não existe número certo aqui, existe decisão declarada. O capítulo de monitoramento do livro de SRE do Google propõe o critério mais útil: todo alerta que chega ao plantão precisa exigir ação humana.
NOC interno ou terceirizado: critérios para a decisão
Estruturar o NOC internamente ou contratar como serviço gerenciado depende de três variáveis. São elas: tamanho e complexidade do ambiente, disponibilidade de pessoal especializado e custo-benefício de cobertura 24×7.
Um NOC interno faz sentido em três condições. A primeira é ambiente complexo com dados que exigem controle total. Além disso, precisa de equipe técnica sênior disponível e orçamento contínuo para pessoas, ferramentas e processos.
Já o NOC terceirizado, em geral parte de um serviço de MSP, atende melhor dois casos. O primeiro é querer cobertura 24×7 sem manter equipe própria em vários turnos. O segundo é ter ambiente que não justifica a especialização interna. Em contrapartida, o modelo entrega escala imediata e prática acumulada de vários clientes.
Uma Central de Eventos 24/7 por uma fração do custo de um NOC próprio.
O KeepGreen assume a triagem dos seus alertas: higieniza o ruído, investiga a causa raiz com IA e aciona sua equipe apenas quando a ação humana é inevitável.
Conclusão
Em resumo, o NOC (Network Operations Center) é a estrutura que transforma monitoramento passivo em gestão ativa da infraestrutura de TI. Três níveis de suporte, processos de escalação e indicadores como MTTD e MTTR formam esse sistema. São eles que permitem tratar o incidente antes que ele chegue ao usuário final.
Escolher entre montar um NOC interno ou terceirizar exige pesar a complexidade do ambiente, a disponibilidade de especialistas e os custos de cobertura contínua. Em ambos os cenários, três coisas separam um NOC que funciona de um que apenas existe. A lista é curta: qualidade dos processos, calibração dos alertas e integração das ferramentas de observabilidade.
A OpServices atua na camada que sustenta essa operação: monitoramento em tempo real, observabilidade e gestão de incidentes. A entrega, na prática, combina plataforma própria e projetos conduzidos junto a parceiros. Para discutir como estruturar a operação de monitoramento da sua empresa, fale com nossos especialistas.
Perguntas Frequentes
O que é NOC em TI?
Qual a diferença entre NOC e SOC?
Quais métricas são usadas para medir a eficiência de um NOC?
Vale a pena terceirizar o NOC?
O que os analistas de NOC monitoram no dia a dia?
