Monitoramento de Kubernetes: Guia completo com exemplos
 Autor: Pedro Tebaldi PM do KeepGreen
 Revisão técnica: Ednilson Correa SRE
Rodar workloads em Kubernetes mudou a forma como times de operação enxergam disponibilidade. Pods nascem, morrem e migram entre nodes em segundos. O ferramental tradicional de monitoramento de servidores não acompanha esse ritmo.
Por isso, o monitoramento de Kubernetes deixou de ser um adicional do projeto. Ele virou camada obrigatória no dia a dia de SREs, DevOps e equipes de plataforma. Sem ele, fica difícil garantir SLAs, controlar custo de cluster e achar a causa raiz de incidentes em microsserviços.
Este guia consolida o que importa para monitorar Kubernetes em produção: o que medir, qual pilha montar e quais limiares usar. Os números e as telas abaixo saíram de um cluster de laboratório montado para este artigo. A versão testada é Kubernetes 1.37.0 com o kube-prometheus-stack 88.6.2, em 01/09/2026. Ao final, você encontra um bloco de perguntas frequentes para revisar os pontos mais comuns.
O que é monitoramento de Kubernetes
Monitoramento de Kubernetes é o processo contínuo de coletar, armazenar e analisar métricas, logs, traces e eventos gerados por todas as camadas de um cluster. O escopo cobre o plano de controle (API server, scheduler, etcd, controller-manager), os nodes, os pods, os containers e as aplicações que rodam dentro deles.
Em outras palavras, monitorar Kubernetes não é a mesma coisa que monitorar uma aplicação ou um servidor isoladamente. A prática exige observar simultaneamente a infraestrutura, a orquestração e o workload, porque um problema raramente fica restrito a uma única camada.
Para uma leitura conceitual sobre a plataforma em si, consulte o guia o que é Kubernetes e como ele organiza pods, deployments e nodes. Esta página foca exclusivamente na camada de observabilidade.
Por que monitorar Kubernetes é diferente
Kubernetes introduz três características que tornam a monitoração mais difícil do que a tradicional. Em primeiro lugar, pods são efêmeros: somem sem aviso e reaparecem em outro node, o que invalida o modelo de host fixo. Além disso, a escala é dinâmica, com autoscaling horizontal subindo réplicas a partir de métricas em tempo real.
Por outro lado, a topologia é constantemente reconfigurada pelo scheduler. Um service hoje atende dez pods e amanhã trinta, sem nenhuma mudança de IP ou DNS na perspectiva do consumidor.
Como resultado, a stack de monitoramento precisa fazer descoberta automática de alvos e lidar com alta cardinalidade de labels. Ela também precisa correlacionar eventos do Kubernetes (Pod scheduled, OOMKilled, ImagePullBackOff) com métricas e logs. Para padronizar essa coleta, veja o guia de OpenTelemetry no Kubernetes.
Os três níveis de observação
Monitorar Kubernetes envolve, simultaneamente, três níveis. No nível de cluster, o foco é capacidade total, saúde do control plane e elegibilidade de nodes. No nível de workload, ficam os deployments, pods, restarts e probes. Por fim, no nível de aplicação, entram latência, taxa de erro e throughput dos serviços que rodam dentro dos containers.
O que monitorar: métricas, logs, traces e eventos
A teoria de observabilidade aplicada a Kubernetes combina os 4 sinais de ouro do SRE: latência, tráfego, erros e saturação. Somado a isso, entram os métodos USE (Utilization, Saturation, Errors) para recursos e RED (Rate, Errors, Duration) para serviços.
Na tabela abaixo estão os principais sinais por camada, como capturá-los e por que cada um importa em produção.
| Sinal | Como coletar | Por que importa |
|---|---|---|
| Saúde do control plane | Métricas do API server, kube-apiserver, scheduler e etcd |
Sem control plane saudável, scheduling e rollouts param |
| Recursos de node | CPU, memória, disco e rede via node-exporter e cAdvisor |
Saturação de node causa eviction e degradação em cascata |
| Estado de objetos | Deployments, replicasets e pods via kube-state-metrics |
Mostra divergência entre estado desejado e real |
| Eventos do cluster | Stream do kubectl get events exportado para o backend |
Sinaliza OOMKilled, ImagePullBackOff e crash loops |
| Logs de aplicação | Agregação via Fluent Bit, Vector ou Loki em formato estruturado | Diagnóstico fino quando a métrica só mostra o sintoma |
| Traces distribuídos | Instrumentação com OpenTelemetry exportando para Tempo, Jaeger ou backend SaaS | Conecta requisições entre serviços e revela gargalos |
Vale destacar que essas quatro fontes (métricas, logs, traces e eventos) não são intercambiáveis. Cada uma responde a um tipo diferente de pergunta operacional. A maturidade do monitoramento aparece justamente em como o time correlaciona os sinais.
O que o kube-state-metrics mostra e o cAdvisor não mostra
Tratar kube-state-metrics e cAdvisor como redundantes é a confusão mais cara da tabela acima. Na verdade, eles medem coisas diferentes: um lê a API do Kubernetes, o outro lê os cgroups do container. Quando o container não existe, portanto, só um dos dois responde.
No laboratório, um pod que pede mais CPU do que qualquer node tem para oferecer ficou parado em Pending. As duas consultas abaixo rodaram no mesmo instante, contra o mesmo cluster.
Esse vazio é a resposta correta: não existe container porque o scheduler nunca colocou o pod em um node. Ainda assim, um painel montado só sobre consumo de recurso mostra um cluster saudável enquanto um deployment inteiro não sobe. Quem enxerga a divergência entre estado desejado e estado real é o kube-state-metrics.
Pilha típica de observabilidade para Kubernetes
Existem três caminhos principais para montar a pilha de observabilidade de um cluster. O primeiro é a stack open-source baseada em Prometheus, Grafana e Alertmanager. O segundo é uma plataforma SaaS comercial. O terceiro são os serviços nativos do provedor cloud (CloudWatch Container Insights, Azure Monitor, Google Cloud Operations).
Cada opção tem vantagens e limitações claras. A comparação abaixo ajuda na decisão.
| Dimensão | Open-source (Prometheus stack) | SaaS comercial | Cloud nativo |
|---|---|---|---|
| Custo inicial | Sem licença | Por host ou ingestão | Por GB e por métrica |
| Esforço operacional | Alto: gestão da própria pilha | Baixo: agente plug and play | Médio: integrado ao IAM do provedor |
| Retenção longa | Requer Thanos, Cortex ou Mimir | Nativa | Nativa, com custo proporcional |
| Portabilidade | Padrão CNCF, aberta | Vendor lock-in moderado | Lock-in alto no provedor |
| Componentes típicos | kube-prometheus-stack |
agente proprietário |
container insights |
A maioria das equipes maduras combina as três abordagens. Por exemplo: Prometheus para métricas de plataforma, uma SaaS para APM e RUM, além do serviço nativo da nuvem para faturamento e governança. O importante, portanto, é evitar duplicidade total, que multiplica custo sem agregar visibilidade.
Ebook: Como sobreviver à fatura cloud?
Nosso framework, Observability Maturity Index, mede a maturidade das operações em nuvem das empresas. Você encontrará: os quatro perfis de empresas, as métricas que você deveria estar medindo, um checklist de avaliação e um plano de ação para 90 dias.
Só o e-mail. Sem spam, e seus dados protegidos pela LGPD.
Limiares de partida para alertar em Kubernetes
Limiar de partida é o valor a partir do qual vale acordar alguém. Ele não sai de opinião: o kube-prometheus já traz um conjunto calibrado pela comunidade. Por isso, os números desta seção saem de lá.
Antes do limiar, porém, vem a escolha do sinal. O erro mais comum é alertar por Running, que não diz nada sobre disponibilidade. Por isso, rodei a comparação no laboratório, com dois namespaces no mesmo cluster.
Nos dois namespaces há pods em Running. No entanto, nenhum pod do namespace de falhas está pronto para receber tráfego. Um espera por node, outro reinicia em laço por estouro de memória e dois respondem à sonda de prontidão na porta errada. Portanto, um alerta baseado em Running não veria nada.
Cada linha da tabela abaixo traz um sinal, a consulta que o mede e a janela de sustentação, com o motivo do valor.
| Sinal | Consulta e janela | Por que esse valor |
|---|---|---|
| Pod fora de Ready | kube_pod_status_ready{condition="true"} == 0 por 15m |
No laboratório os três pods do namespace de falhas ficaram Running sem nunca entrar em Ready |
| Reinício em laço | waiting_reason="CrashLoopBackOff" >= 1 por 15m |
O contador de restart cresce sozinho: 8 reinícios em 20 minutos no pod de teste, sem distinguir laço de falha isolada |
| Container preso em espera | waiting_reason != "CrashLoopBackOff" > 0 por 1h |
A janela é maior porque falta de imagem ou de ConfigMap costuma se resolver na própria sequência do deploy |
| Réplicas abaixo do desejado | spec_replicas > replicas_available com changes(...[10m]) == 0 por 15m |
A segunda condição é o que impede o alerta de disparar durante todo rolling update |
| CPU comprometida | sum(requests) > sum(allocatable) por 10m |
Passado esse ponto o próximo pod fica Pending, exatamente como o pedido de 16 cores do laboratório |
| Latência do API server | histogram_quantile(0.99, ...{verb=~"GET|LIST"}) |
O laboratório ocioso mediu 4,95 ms de p99: é a linha de base contra a qual ler o número do seu cluster |
Tão importante quanto o limiar é a janela de sustentação, ou seja, o for da regra. Ela é o que separa o incidente do soluço. Na captura abaixo, três instâncias já passaram dos 15 minutos e estão em FIRING, enquanto a quarta ainda conta o tempo em PENDING.
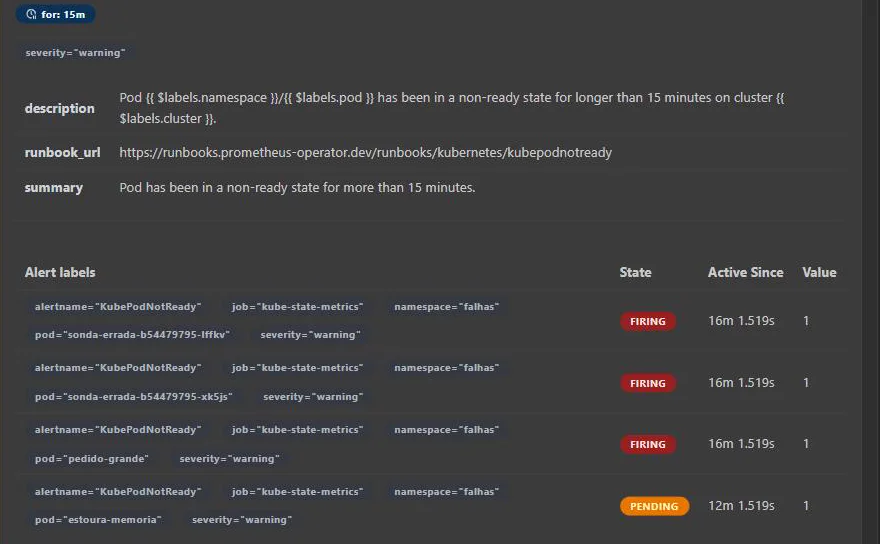
Além disso, há um detalhe nessas regras que resolve a queixa mais comum de quem opera cluster: o alerta que dispara a cada deploy. A regra de réplicas, por sua vez, não olha só a diferença entre desejado e disponível.
Em outras palavras, a função changes() conta quantas vezes o número de réplicas atualizadas mudou nos últimos 10 minutos. Durante um rolling update esse contador se mexe, então a condição dá falso e o alerta se cala. Quando o rollout trava, por outro lado, o contador congela e o alerta passa.
Em última análise, essa é a diferença entre calibrar o limiar e apenas subir o valor até parar de incomodar.
Exemplos de monitoramento Kubernetes
A teoria fica mais clara com exemplos visuais. O primeiro print vem do cluster de laboratório descrito na introdução, capturado no Grafana 13.2.0 em 01/09/2026.
Trata-se do painel Namespace (Pods), que acompanha o kube-prometheus-stack. No gráfico aparece o platô de CPU depois que a carga sintética entrou. Em seguida, a tabela lista cada pod pelo nome, com o consumo medido ao lado do request declarado.
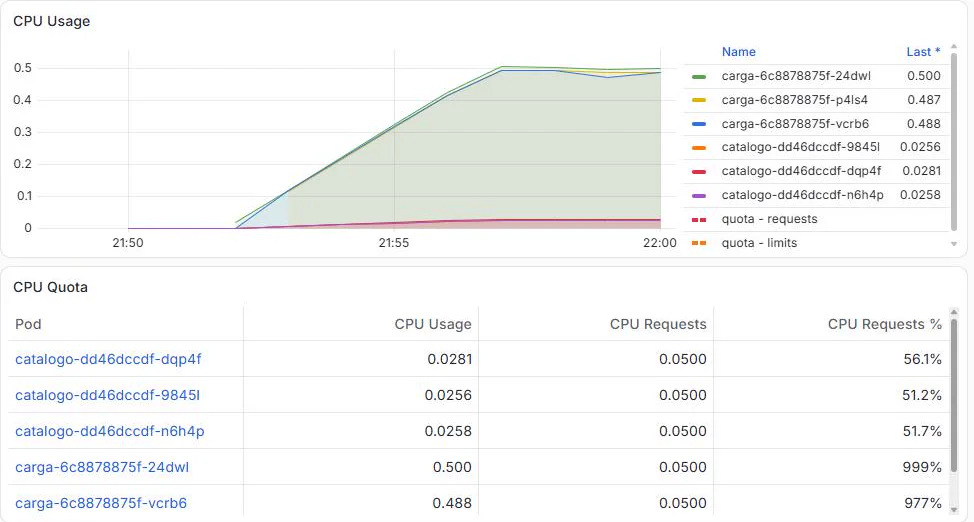
Repare na coluna da direita: os pods de carga aparecem em 999% e 977% do request declarado de 0,05 core. Requests subdimensionados ficam invisíveis enquanto sobra CPU no node. Por outro lado, eles cobram a conta no primeiro momento de disputa. Nesse instante o scheduler decide pelo request declarado, ou seja, nunca pelo consumo real.
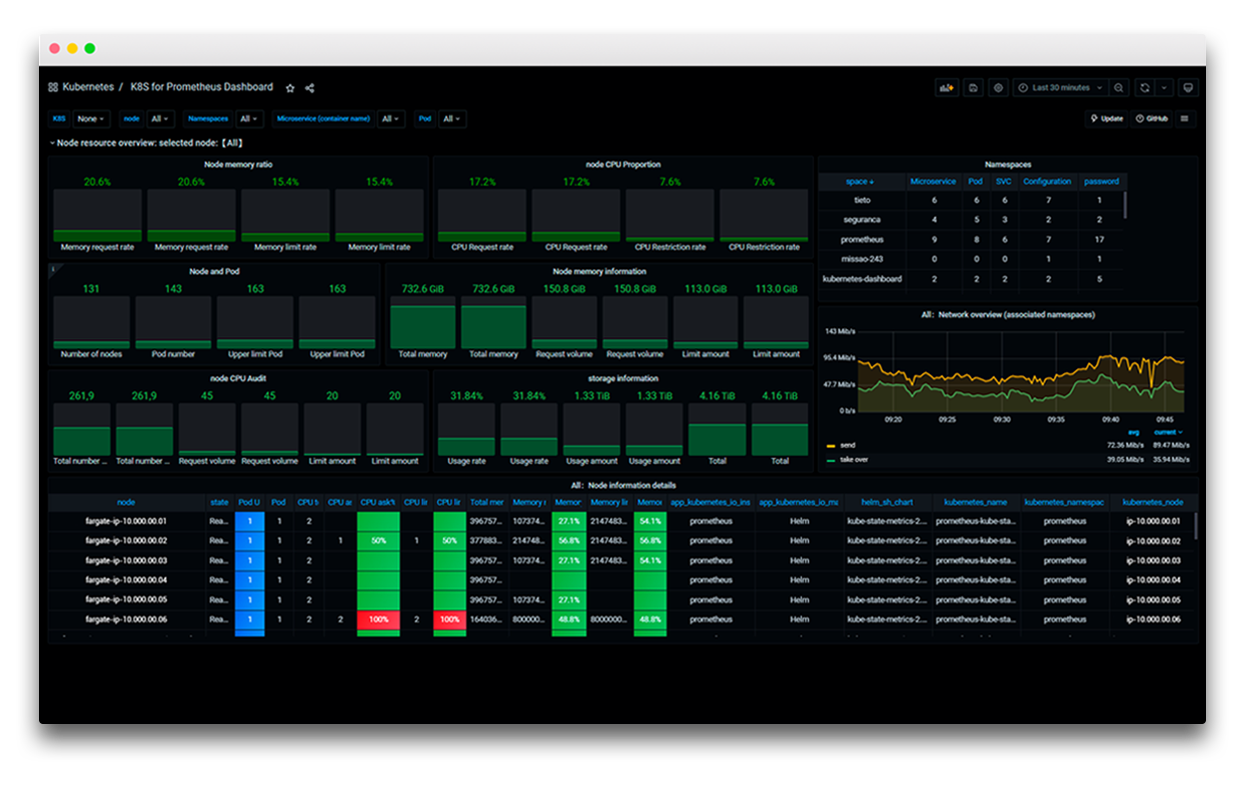
Os dois prints seguintes vêm de ambientes de produção monitorados pela OpServices, com os painéis descaracterizados para omitir informação sensível de cliente.
O segundo exemplo apresenta uma visão centralizada de métricas de containers e microsserviços. O dashboard reúne consumo de memória, uso de CPU, banda por segundo e informações de nodes e pods em uma única tela. Dessa forma, a triagem de incidentes fica mais rápida para o time de operação.
Em seguida, o terceiro dashboard detalha a camada de nodes e pods. A visualização lista cada node com seu respectivo estado. Além disso, expõe métricas de CPU, memória e disco em granularidade individual, o que aponta o componente saturado em um cluster grande.
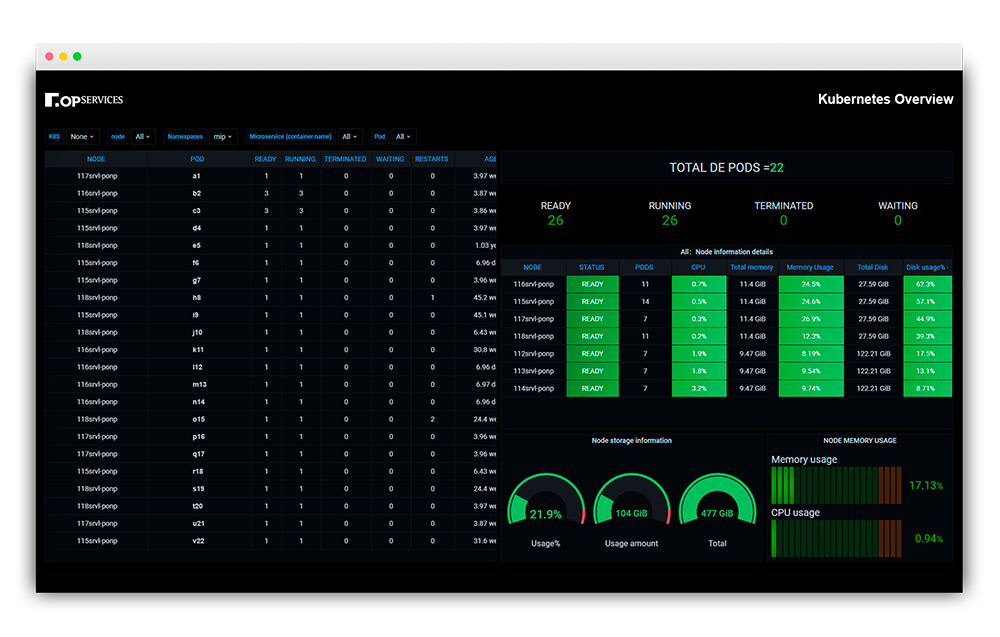
Em suma, os três exemplos seguem o mesmo princípio: dashboards organizados por camada (cluster, node, pod e container) e linkados entre si. Assim, a navegação acompanha o fluxo natural da investigação.
Principais desafios de monitorar Kubernetes em produção
Mesmo com a pilha certa, alguns desafios aparecem em todo cluster que cresce. Os mais comuns são quatro.
O primeiro é a cardinalidade alta. Cada combinação única de labels gera uma série temporal. O laboratório deste artigo dá a escala do problema: três nodes e doze pods de aplicação produziram 52.747 séries ativas. Vale destacar que nenhuma aplicação estava instrumentada.
Mais revelador é de onde elas vêm. Só o API server responde por 28.881 séries, ou 54,8% do total, contra 1.953 do próprio kube-state-metrics. Por isso, vale aplicar relabeling agressivo para descartar labels sem valor operacional, como pod_template_hash.
O segundo é o custo de logs. Em ambientes com milhares de réplicas, a ingestão supera com facilidade o orçamento de observabilidade. Soluções como Loki ajudam por indexar apenas labels em vez do conteúdo completo. Ainda assim, é necessário definir políticas de retenção por severidade.
O terceiro desafio é o ruído de alertas. Pods reiniciam por design em rolling updates, então alerta mal calibrado dispara o tempo inteiro. A melhor prática é alertar por sintoma voltado ao usuário: latência fora do SLO ou taxa de erro acima do budget. Causa técnica isolada não merece plantão.
Por fim, o storage efêmero de pods exige que logs e métricas saiam do node antes do término do container. Caso contrário, dados de diagnóstico se perdem no momento exato em que são mais necessários.
A armadilha da conta de capacidade
Existe ainda um quinto desafio, que aparece só quando alguém usa o painel para decidir compra de node. A soma ingênua de requests conta também o pod que nunca foi agendado, porque o objeto existe na API mesmo sem node. Como antes, as duas consultas abaixo rodaram no mesmo cluster e no mesmo instante.
Treze vezes separam as duas contas. Um único pod em Pending, pedindo 16 cores que ninguém tem, respondia por 16 dos 17,35 cores contabilizados. Corrige-se isso com o group_left da segunda consulta, que só deixa passar o pod já colocado em algum node pelo scheduler.
Na prática, o efeito é caro nos dois sentidos. Para cima, a conta inflada justifica um node que ninguém precisa. Para baixo, em contrapartida, ela esconde que o cluster tem folga real de 96%, enquanto um deployment segue parado esperando um recurso impossível.
Boas práticas para monitoramento Kubernetes em produção
Quatro boas práticas separam um monitoramento que apenas registra de um monitoramento que sustenta a operação. Antes de tudo, defina SLOs por serviço em vez de componente de infraestrutura. O SLO traduz expectativa de negócio em métrica observável e orienta priorização de incidentes.
Em segundo lugar, organize dashboards por camada. Cluster, namespace, deployment, pod e container devem ter painéis dedicados, conectados por links contextuais. Vale dizer que dashboards monolíticos só funcionam em clusters pequenos.
Outro ponto é usar autoscaling baseado em métricas reais em vez de valores arbitrários de CPU. Métricas de latência, fila de mensagens ou requisições por segundo refletem melhor a demanda do serviço.
Por último, trate a configuração de observabilidade como código. Manifests de ServiceMonitor, regras de alerta e dashboards do Grafana devem viver no repositório junto com a aplicação, idealmente sob GitOps.
Dessa forma, o chart do kube-prometheus-stack entrega os três em versão fixada e torna o cluster reproduzível. Esse princípio se conecta aos conceitos do guia o que é observabilidade e de soluções de observabilidade em escala corporativa.
Para aprofundamento técnico, a documentação oficial do projeto e a lista de projetos graduados pela CNCF são referências constantemente atualizadas pela comunidade. Vale também consultar a capítulo do livro de SRE do Google sobre sistemas distribuídos.
Visibilidade completa de pods, nodes e clusters Kubernetes em produção.
Monitoramos health checks, consumo de recursos e eventos de orquestração para equipes que rodam workloads críticos em containers.
Conclusão
Monitorar Kubernetes exige uma abordagem diferente do monitoramento tradicional de servidores. O ambiente é dinâmico, com pods efêmeros, escala automática e topologia em constante mudança. Isso exige coleta automática, cardinalidade controlada e correlação entre métricas, logs, traces e eventos.
Em resumo, uma operação madura combina os sinais certos com a pilha adequada, seja ela open-source, SaaS ou cloud nativo. Somado a isso, entram dashboards por camada, alertas com janela de sustentação calibrada e observabilidade tratada como código. Quando esses pilares estão no lugar, o cluster deixa de ser uma caixa preta e passa a sustentar SLAs reais.
Para acelerar essa jornada com apoio especializado, fale com um especialista da OpServices e descubra como elevar a maturidade do monitoramento do seu ambiente Kubernetes.
Perguntas Frequentes
O que é monitoramento de Kubernetes?
Quais métricas monitorar em Kubernetes?
API server e do etcd. No node, CPU, memória, disco e rede via node-exporter e cAdvisor. No workload, estado de deployments e pods via kube-state-metrics, com restarts e probes. Na aplicação, latência, taxa de erro e throughput (sinais de ouro do SRE). Eventos do cluster como OOMKilled e ImagePullBackOff completam o quadro e devem ser exportados para o mesmo backend.Prometheus e Grafana são suficientes para monitorar Kubernetes?
kube-state-metrics, node-exporter e Alertmanager via Helm chart kube-prometheus-stack. Para retenção longa, é necessário adicionar Thanos, Cortex ou Mimir. Para logs e traces, a pilha precisa crescer com Loki ou Elasticsearch para logs e Tempo ou Jaeger para traces. Em clusters muito grandes ou com requisitos de APM avançado, plataformas SaaS comerciais costumam complementar ou substituir parte da stack open-source.Quais são os principais desafios de monitorar Kubernetes em produção?
Como funciona o kube-state-metrics?
kube-state-metrics é um serviço que escuta a API do Kubernetes e expõe, em formato Prometheus, métricas sobre o estado dos objetos do cluster: deployments, replicasets, pods, jobs, statefulsets e demais recursos. Ele não mede consumo de recurso (isso fica com node-exporter e cAdvisor) e sim divergência entre estado desejado e estado real. Por exemplo, sinaliza pods em Pending, deployments com réplicas indisponíveis ou jobs falhos, dados essenciais para alertas de saúde do workload.